Camada de memória compartilhada e de propriedade do usuário que conecta múltiplos agentes de IA
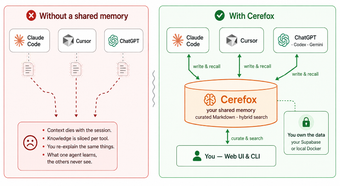
cerefox, construído por Fstamatelopoulos, é uma camada de memória compartilhada que centraliza o conhecimento para agentes de IA e remove as fronteiras de sessão entre assistentes. A ferramenta captura e expõe memória persistente para permitir geração aumentada por recuperação e recordação entre agentes, integrando-se ao Protocolo de Contexto de Modelo (MCP) e busca apoiada por vetores. Ela agrupa busca híbrida, fragmentação de Markdown ciente do cabeçalho, filtros de metadados JSONB e logs de auditoria. Desenvolvedores, usuários avançados de IA e pesquisadores que executam múltiplos agentes ganham uma base de conhecimento única, controlada pelo usuário, para fluxos de trabalho coordenados e contexto a longo prazo.
Quais tarefas você pode realmente usar isso?
O aplicativo funciona como um repositório de conhecimento persistente que os agentes podem tanto ler quanto escrever, permitindo que o conteúdo produzido em uma sessão apareça em outra. Ele aceita Markdown, texto simples e arquivos .docx e preserva o contexto da seção com divisão consciente de cabeçalhos, o que ajuda os agentes a recuperar seções específicas do documento em vez de arquivos inteiros. As integrações suportadas incluem clientes compatíveis com MCP e ferramentas que executam comandos de shell, possibilitando casos de uso desde a recuperação de sessões de código até chats de pesquisa entre diferentes assistentes.
Quão precisas e verificáveis são suas recuperações?
A busca combina recuperação de texto completo BM25 com similaridade semântica de vetor, funcionando em um backend Postgres com capacidades de vetor para melhorar a relevância dos resultados. A ferramenta expõe filtragem de metadados indexados em JSONB para consultas restritas, e um log de auditoria imutável e somente de anexação registra leituras e gravações para rastreabilidade. Esses elementos suportam fluxos de trabalho de geração aumentada por recuperação onde a verificação é importante, pois os usuários podem filtrar por tags ou inspecionar o histórico de auditoria para um determinado documento ou consulta.
O que é necessário para implantar e executar na prática?
A implantação requer Node.js 20+ para o CLI e uma instância Postgres com suporte a vetores; o projeto oferece Docker para instalações locais e Supabase para implementação hospedada. Um modo local pode operar offline usando modelos de incorporação locais como nomic-embed-text, que mantém as incorporações no dispositivo. Essas opções de implantação oferecem flexibilidade, mas também exigem alguma configuração de sistemas e um banco de dados funcional com indexação de vetores habilitada.
Quão bem ele suporta engenharia e governança multi-agente?
O design prioriza a coordenação entre agentes e uso simultâneo: o suporte nativo ao MCP permite que agentes em diferentes máquinas compartilhem contexto, e o bloqueio otimista impede que os agentes sobrescrevam as atualizações uns dos outros. Um painel de análise exibe os principais documentos e padrões de acesso para que as equipes possam monitorar o uso dos agentes. Juntas, essas peças tornam a ferramenta adequada para fluxos de trabalho de engenharia que requerem memória persistente e auditável em vez de estado de sessão efêmero.
Uma escolha prática para equipes tecnicamente proficientes que desejam controle
A ferramenta é uma opção prática para desenvolvedores e pesquisadores que precisam de uma memória persistente e controlada pelo usuário em vários agentes de IA. Sua arquitetura recompensa equipes capazes de gerenciar hospedagem, embeddings e ajuste de recuperação, enquanto usuários que buscam uma solução plug-and-play, sem operações, podem achar que a configuração exige muito. Para equipes preparadas para operar e governar sua própria camada de conhecimento, a ferramenta oferece um caminho claro para fluxos de trabalho de agentes coordenados e registros responsáveis.